Apa Itu Token dalam AI: Cara Kerja Tokenisasi, Biaya API, dan Dampaknya pada Konten


Token dalam AI adalah potongan teks terkecil berupa kata pendek, suku kata, karakter, atau tanda baca yang diproses model bahasa besar. Setiap sistem kecerdasan buatan berbasis teks memakai satuan ini untuk membaca instruksi, menjalankan penalaran, menentukan batas kapasitas memori aktif, dan menghitung besaran biaya API Anda.
Banyak praktisi dan pemilik usaha masih menyamakan satu token dengan satu kata utuh. Padahal, satuan ini memengaruhi batas panjang obrolan harian, tagihan API (jalur integrasi sistem ke server AI), hingga keutuhan pembacaan artikel oleh mesin pencari AI. Memahaminya membantu Anda menjaga anggaran sekaligus memenuhi standar artikel konten berkualitas.
Pengertian Token dalam AI pada Large Language Model (LLM)

Large Language Model (LLM) adalah model kecerdasan buatan berbasis teks berukuran besar yang dilatih memprediksi rangkaian kata dan menyusun jawaban. Komputer tidak membaca kalimat layaknya mata manusia, melainkan mengolah seluruh instruksi melalui operasi hitung matematika terhadap deretan angka.
Saat Anda mengetik prompt pada berbagai pilihan di daftar Large Language Model populer, teks mentah tidak langsung masuk ke jaringan saraf AI. Sistem terlebih dahulu menjalankan tiga tahapan pemrosesan yang saling terhubung sebelum menampilkan jawaban di layar Anda:
- Pemecahan teks menjadi token: Perangkat lunak pemecah teks (tokenizer) memotong kalimat Anda menjadi unit kecil berupa kata umum pendek, pecahan suku kata, angka, spasi, atau tanda baca.
- Pemetaan nomor indeks (token ID): Sistem mencocokkan setiap potongan teks dengan kamus kosakata tetap milik model (vocabulary) yang memuat 100.000 hingga 256.000 entri, lalu mengubahnya menjadi nomor indeks angka unik.
- Konversi ke vector embeddings: Model menerjemahkan deretan angka indeks tersebut ke representasi angka berdimensi tinggi yang disebut vector embeddings. Melalui cara ini, model paham bahwa kata “dokter” lebih dekat maknanya dengan “rumah sakit” daripada “sepeda” sebelum memprediksi token berikutnya.
Perbedaan pemecahan ini terlihat jelas ketika Anda membandingkan kata berbahasa Inggris dan bahasa Indonesia. Kata umum Inggris seperti “marketing” sering kali dikenali sebagai satu entri utuh di kamus model sehingga hanya memakan satu token.
Sebaliknya, kata berimbuhan bahasa Indonesia seperti “produktivitas” atau “menggemakan” jarang tersimpan secara utuh dalam kamus global. Akibatnya, kata “produktivitas” bisa terpecah menjadi beberapa potongan suku kata seperti ["pro", "duktiv", "itas"], yang masing-masing dihitung sebagai satu token tersendiri.
Bagi Anda yang memakai ChatGPT atau Gemini langsung lewat chat harian tanpa API, satuan token tetap menentukan batas ruang memori aktif dalam satu sesi (context window). Saat total token obrolan mendekati kapasitas penuh, AI mulai melupakan instruksi di awal percakapan, memotong jawaban panjang di tengah jalan, atau menolak lampiran dokumen berukuran besar.
Cara Kerja Tokenisasi dalam AI dan Evolusi Ukuran Kosakata
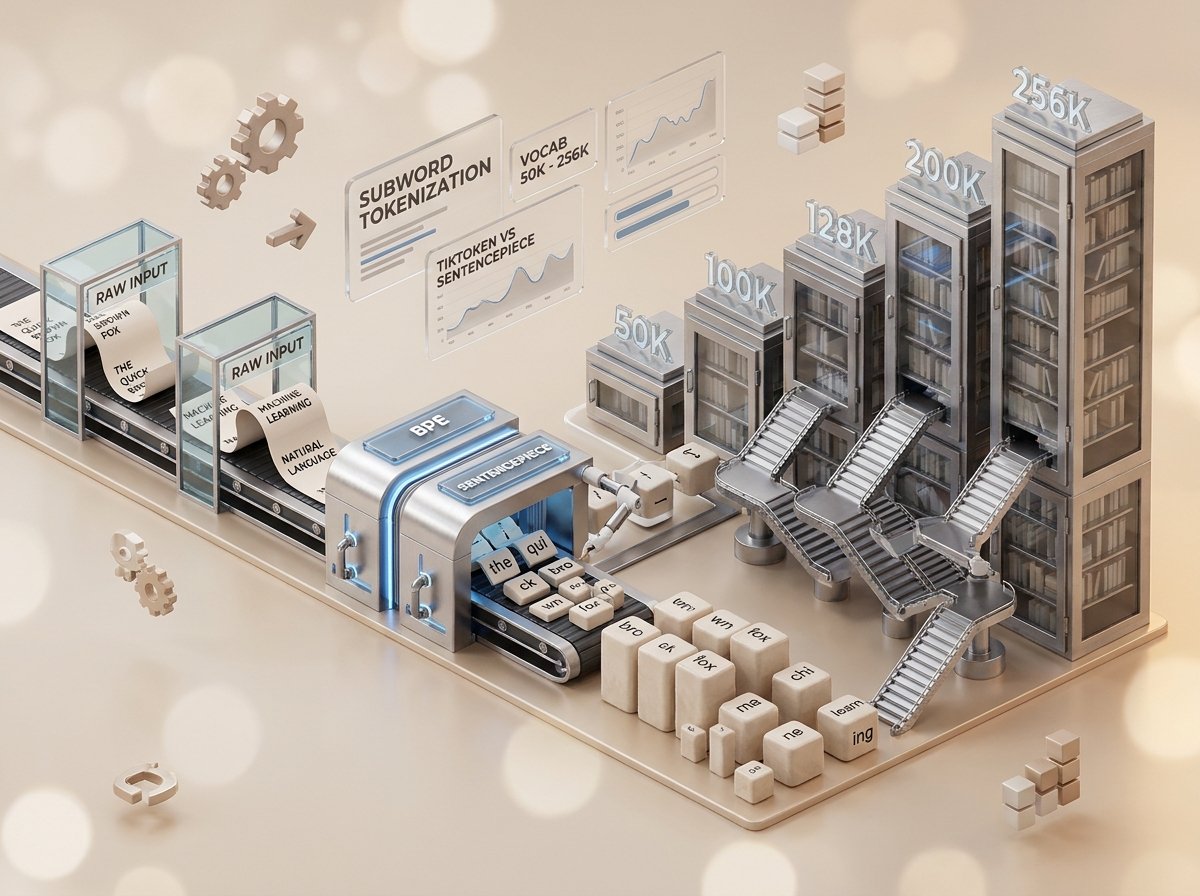
Tokenisasi menentukan seberapa efisien model AI membaca dokumen panjang tanpa kehilangan konteks makna. Perancangan tokenizer selalu menuntut keseimbangan antara jumlah potongan token per kalimat dan ukuran kamus kosakata yang tersimpan di memori server.
Tiga Metode Pemecahan Teks dalam Pemrosesan Bahasa Alami
Ilmu pemrosesan bahasa alami mengembangkan tiga pendekatan utama sebelum menetapkan satu standar industri yang paling efisien. Setiap pendekatan membawa konsekuensi langsung terhadap kapasitas memori dan ketepatan pemahaman konteks.
- Word-based tokenization: Metode generasi awal ini memisahkan teks berdasarkan spasi dan tanda baca sehingga satu kata menjadi satu token. Kelemahan utamanya, kamus cepat membengkak dan kata baru di luar kamus langsung diganti tanda
[UNK](tidak dikenali) hingga merusak makna kalimat. - Character-based dan byte-based tokenization: Pendekatan ini memecah kalimat hingga level huruf tunggal atau byte UTF-8. Meskipun bebas dari error
[UNK], kata panjang seperti “internationalization” terpecah menjadi 20 token huruf sehingga urutan teks membengkak drastis dan memperlambat komputasi GPU. - Subword tokenization: Teknik ini memecah kata panjang atau jarang muncul menjadi beberapa potongan suku kata agar tetap dikenali model AI. Kata umum tetap utuh sebagai satu token, sedangkan kata majemuk seperti “internationalization” dipecah menjadi potongan bermakna seperti
["inter", "national", "ization"].
Perbedaan Algoritma BPE, WordPiece, Unigram, dan SentencePiece
Di atas prinsip subword tokenization, penyedia AI menerapkan empat mekanisme pemecahan teks dengan pendekatan berbeda. Setelah teks terpecah, model memetakan kedekatan makna antar-token dengan logika semantik yang sejalan dengan konsep Latent Semantic Indexing pada pencarian informasi.
- Byte-Pair Encoding (BPE) & tiktoken OpenAI: Algoritma dominan ini membangun kosakata dari bawah ke atas dengan menggabungkan pasangan karakter tersering hingga mencapai target kamus. Pada implementasi pustaka
tiktokenOpenAI, Byte-Level BPE dipadukan dengan aturan pemisah pola berbasis spasi yang dibangun dengan bahasa pemrograman Rust agar proses pemecahan teks berlangsung tiga hingga enam kali lebih cepat. - WordPiece: Google mengembangkan metode ini untuk model BERT dengan memilih penggabungan sub-kata paling efisien secara statistik. Potongan lanjutan di tengah atau akhir kata ditandai memakai prefiks
##, misalnya membagi “playing” menjadi["play", "##ing"]. - Unigram: Algoritma ini bekerja terbalik dari atas ke bawah dengan memulai dari daftar kandidat suku kata berukuran sangat besar. Pada setiap putaran, sistem memangkas potongan paling jarang berguna hingga ukuran kamus tepat mencapai batas target.
- SentencePiece: Kerangka kerja yang menopang perkembangan Google Gemini AI ini memperlakukan teks sebagai rangkaian karakter teks mentah tanpa harus memotongnya berdasarkan spasi terlebih dahulu. SentencePiece menyimpan spasi sebagai simbol khusus
▁di dalam kamus sehingga teks bisa dikembalikan persis utuh dan efisien bagi bahasa tanpa spasi seperti Mandarin atau Jepang.
Perbandingan Ukuran Kosakata Antar Model AI
Vendor AI terus memperbesar kapasitas kamus kosakata dari kisaran 32.000 token menuju 256.000 token agar lebih banyak suku kata non-Inggris tertampung dalam satu token tunggal. Namun, memperbesar ukuran kamus jauh melampaui 256.000 token mulai kurang efisien karena menyedot memori GPU berlebihan untuk entri kata yang sangat jarang dipakai.
Rasio Token Bahasa Indonesia vs Bahasa Inggris dan Cara Menghitungnya
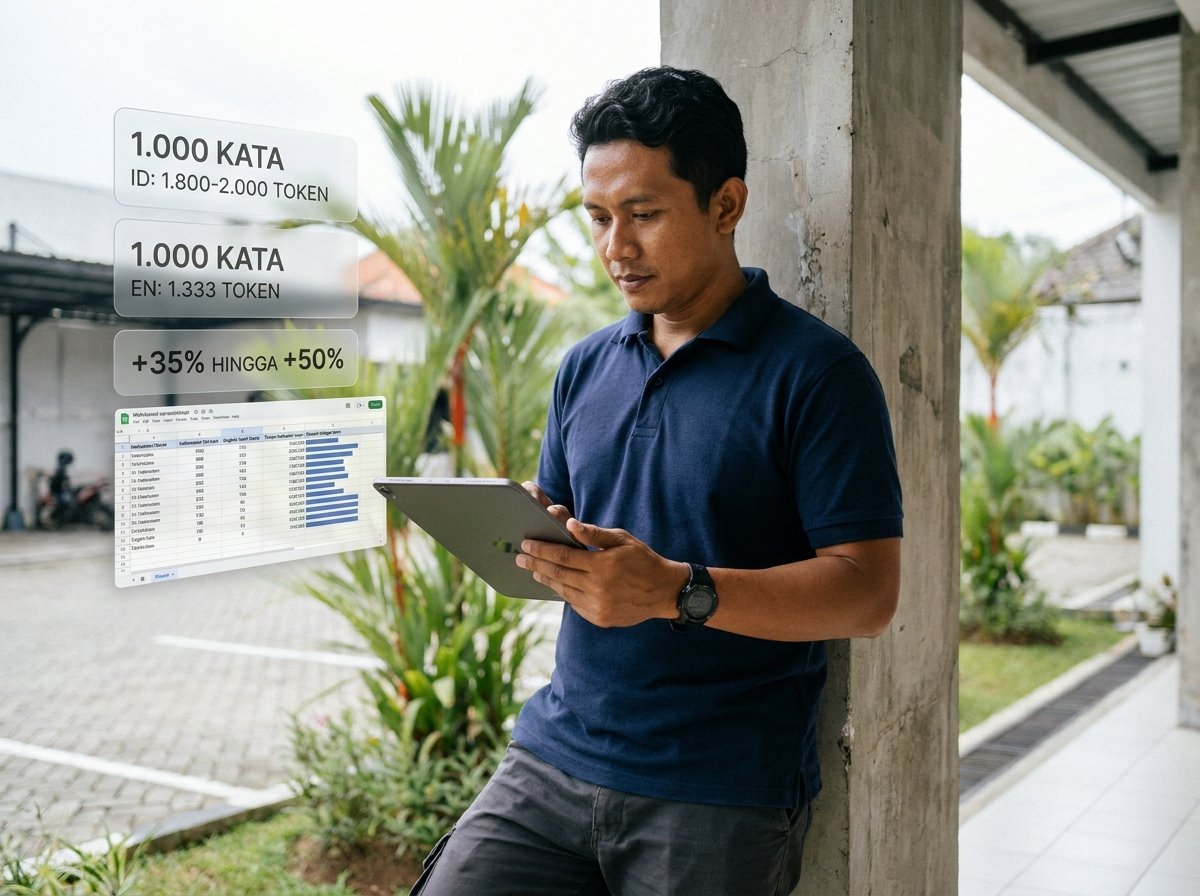
Di Indonesia sendiri, pengguna dan perusahaan membayar biaya tokenisasi 35% hingga 50% lebih mahal daripada pengguna bahasa Inggris untuk muatan informasi yang sama. Fenomena ketimpangan paritas tokenizer lintas bahasa ini telah terbukti secara empiris melalui riset paritas tokenizer Universitas Oxford oleh Petrov et al. pada konferensi NeurIPS 2023.
Karena mayoritas data pelatihan didominasi bahasa Inggris, teks bahasa Indonesia dengan rasio 1,8 hingga 2,0 token per kata mengalami pemecahan sub-kata lebih panjang. Ketimpangan ini memicu tiga dampak langsung: tagihan API membengkak, waktu tunggu jawaban (latency) melambat, dan ruang memori aktif yang sanggup dibaca AI dalam satu sesi (context window) ikut menyempit.
💡 Rumus Rasio Paritas Tokenizer (Premi Tokenisasi):
Premi Tokenisasi = Jumlah Token Bahasa Indonesia ÷ Jumlah Token Bahasa Inggris (Makna Setara)
Sebagai gambaran nyata, bayangkan sebuah perusahaan logistik dan ekspedisi nasional memproses panduan layanan pelanggan dalam bahasa Indonesia dibandingkan padanan bahasa Inggrisnya. Dengan asumsi panjang kedua naskah sama-sama 1.000 kata, teks bahasa Inggris (rasio 1,333 token per kata) hanya menghasilkan 1.333 token.
Sementara itu, naskah 1.000 kata bahasa Indonesia dengan rasio 1,8 hingga 2,0 token per kata mengonsumsi 1.800 hingga 2.000 token. Jika Anda membagi angka tersebut, batas bawahnya menghasilkan 1.800 ÷ 1.333 = 1,35x (35% lebih boros token) dan batas atasnya mencapai 2.000 ÷ 1.333 = 1,50x (50% lebih boros token).
Di luar teks prosa, elemen teknis seperti baris kode pemrograman, tautan URL panjang, deretan angka, emoji, serta format JSON berulang juga menyedot token jauh lebih cepat. Tabel berikut merangkum patokan konversi konsumsi token untuk berbagai jenis input teks maupun data teknis.
Cara Menghitung Jumlah Token Secara Eksak Sebelum Mengirim API
Anda tidak perlu menebak jumlah token secara manual sebelum menjalankan proyek konten atau mengirim permintaan ke server AI. Anda bisa memilih salah satu dari dua jalur pengecekan resmi sesuai kebutuhan tim:
- Untuk pengguna non-teknis (tanpa coding): Cukup salin dan tempel naskah Anda ke alat penghitung token resmi berbasis browser, seperti OpenAI Tokenizer atau panel hitung token di Google AI Studio. Alat ini langsung menampilkan total angka beserta sorotan warna untuk setiap potongan token.
- Untuk tim pengembang: Jalankan skrip Python lokal memakai pustaka
tiktokenatauAutoTokenizeragar batas anggaran selalu terkendali otomatis. Pastikan Anda memanggil nama skema sepertio200k_basesecara eksplisit karena pustaka lama sering keliru kembali kecl100k_base.
import tiktoken
from transformers import AutoTokenizer
# 1. Bandingkan skema OpenAI: o200k_base (200K) vs cl100k_base (100K)
enc_o200k = tiktoken.get_encoding("o200k_base")
enc_cl100k = tiktoken.get_encoding("cl100k_base")
teks_id = "Optimasi website bisnis di Indonesia menggunakan arsitektur silo dan GEO."
teks_en = "Business website optimization in Indonesia using silo architecture and GEO."
print(f"Indonesia (cl100k_base) : {len(enc_cl100k.encode(teks_id))} token")
print(f"Indonesia (o200k_base)  : {len(enc_o200k.encode(teks_id))} token")
print(f"Inggris   (o200k_base)  : {len(enc_o200k.encode(teks_en))} token")
# 2. Cek token pada model open-weight Meta Llama (128K BPE)
# Catatan: repositori Llama memerlukan login & izin akses Hugging Face
tok_llama = AutoTokenizer.from_pretrained("meta-llama/Llama-3.1-8B")
print(f"Indonesia (Llama BPE)   : {len(tok_llama.encode(teks_id))} token")
print(f”Indonesia (Llama BPE) : {len(tok_llama.encode(teks_id))} token”)
Setelah aplikasi mengirim panggilan API, server AI membalas dengan objek JSON pencatatan konsumsi (usage atau usage_metadata). Contoh perbandingan yang disederhanakan di bawah ini menunjukkan bagaimana model penalaran memisahkan token input awal, token tersimpan di cache, token berpikir internal, serta token jawaban akhir.
{
  "standard_api_usage": {
    "prompt_tokens": 56,
    "completion_tokens": 128,
    "total_tokens": 184
  },
  "reasoning_api_usage": {
    "initial_input_tokens": 8192,
    "total_input_tokens": 8192,
    "total_cached_tokens": 7680,
    "total_thought_tokens": 4096,
    "total_output_tokens": 2048,
    "total_tokens": 14336
  }
}
Mengapa Harga Token Output Lebih Mahal daripada Token Input?

Seluruh penyedia API AI mematok harga token output dua hingga lima kali lipat lebih tinggi daripada token input. Selisih tajam ini bukan sekadar strategi margin bisnis, melainkan dampak langsung dari beban perangkat keras GPU pada dua tahap kerja inferensi yang bertolak belakang.
Mengacu pada penjelasan teknis fase prefill dan decode pada inferensi LLM, server memproses seluruh token input secara paralel sekaligus pada tahap prefill. Seluruh teks instruksi sudah tersedia sejak awal sehingga GPU hanya membaca bobot model satu kali lalu mengolah ribuan token bersamaan. Proses paralel ini menjaga utilisasi GPU di angka 80% hingga 98% dengan waktu respons token pertama sekitar 200 hingga 500 milidetik.
Begitu token jawaban pertama muncul, server masuk ke tahap decode yang berjalan satu per satu secara berurutan. Setiap kali memunculkan satu token baru, GPU wajib membaca ulang seluruh miliaran bobot model beserta memori sementara yang disebut KV Cache (penyimpan hasil pembacaan teks sebelumnya agar tidak dihitung dari nol).
Akibat kemacetan jalur transfer memori tersebut, utilisasi komputasi GPU anjlok ke kisaran 15% hingga 35% dan menyita lebih dari 90% total waktu eksekusi server. Hal serupa berlaku pada thinking tokens (token proses penalaran internal sebelum jawaban tampil) karena seluruhnya dihasilkan lewat proses decode dan ditagih penuh menggunakan tarif token output.
Simulasi Perhitungan Biaya API untuk Operasional Bisnis
Untuk memperkirakan pengeluaran operasional bulanan secara akurat, tim teknis maupun divisi keuangan perlu memisahkan pos input reguler, input tersimpan di cache, dan total output. Anda dapat menggunakan rumus standar industri di bawah ini sebagai acuan hitung.
📐 Rumus Perhitungan Biaya API LLM:
Total Biaya API = ((Token Input Reguler ÷ 1.000.000) × Tarif Input) + ((Token Input Cached ÷ 1.000.000) × Tarif Cached) + (((Token Output + Token Thinking) ÷ 1.000.000) × Tarif Output)
Mari kita terapkan rumus tersebut pada skenario perusahaan logistik dan ekspedisi nasional sebelumnya. Layanan chatbot pelacakan paket menangani 10.000 interaksi per bulan memakai model kelas menengah bertarif $2,00 per 1 juta token input dan $10,00 per 1 juta token output. Rata-rata tiap sesi memuat 1.000 kata input dan 250 kata output dengan kurs ilustrasi Rp16.000/USD.
Pada simulasi dasar ini, kami mengasumsikan belum ada fitur caching dan belum memakai thinking tokens agar selisih antar-bahasa terlihat jelas:
- Skenario bahasa Indonesia (koefisien 1,8 token per kata): Setiap sesi memakai 1.800 token input (total 18 juta token/bulan) dan 450 token output (total 4,5 juta token/bulan). Biaya input sebesar 18 × $2,00 = $36,00, sedangkan biaya output sebesar 4,5 × $10,00 = $45,00, sehingga total tagihannya mencapai $81,00/bulan (sekitar Rp1.296.000/bulan).
- Skenario bahasa Inggris (patokan 1.333 token per 1.000 kata): Setiap sesi memakai 1.333 token input (total 13,33 juta token/bulan) dan 333 token output (total 3,33 juta token/bulan). Biaya input sebesar 13,33 × $2,00 = $26,66, sedangkan biaya output sebesar 3,33 × $10,00 = $33,30, sehingga total tagihannya hanya $59,96/bulan (sekitar Rp959.360/bulan).
Simulasi ini memperlihatkan dua pelajaran penting bagi pengelolaan anggaran bisnis Anda. Pertama, selisih biaya mencapai $21,04/bulan (Rp336.640/bulan) atau 35,09% lebih mahal saat beroperasi dalam bahasa Indonesia. Kedua, meski panjang jawaban hanya seperempat dari panjang input, pos biaya output ($45,00) justru melampaui biaya input ($36,00).
Perbedaan Token AI dengan Kredit SaaS, API Key, dan Token Kripto

Pencari informasi di Indonesia sering kali mencampuradukkan istilah token komputasi bahasa dengan tiga entitas digital lain yang kebetulan memakai nama serupa. Memahami batas keempatnya mencegah kesalahan saat Anda membaca kontrak langganan perangkat lunak maupun merancang anggaran integrasi sistem.
Sebagai contoh, saat tim Anda memakai berbagai tools AI untuk SEO berbasis langganan, potongan kuota biasanya memakai sistem kredit tetap per fitur. Mempersingkat kalimat prompt akan langsung menurunkan tagihan API berbasis token, tetapi belum tentu menghemat kuota pada platform SaaS yang mengenakan tarif kredit tetap per klik.
Cara Menghemat Penggunaan Token AI untuk Operasional Bisnis
Pemborosan anggaran AI terbesar dalam skala perusahaan sering terjadi pada percakapan panjang multi-giliran. Karena panggilan API pada dasarnya tidak menyimpan ingatan permanen, aplikasi terus mengirim ulang seluruh riwayat instruksi sistem dan tanya-jawab sebelumnya pada setiap pesan baru.
Akibat mekanisme tersebut, volume token input melonjak berlipat ganda seiring bertambahnya giliran percakapan. Tim Anda dapat memotong pembengkakan biaya operasional secara signifikan melalui lima langkah teknis berikut:
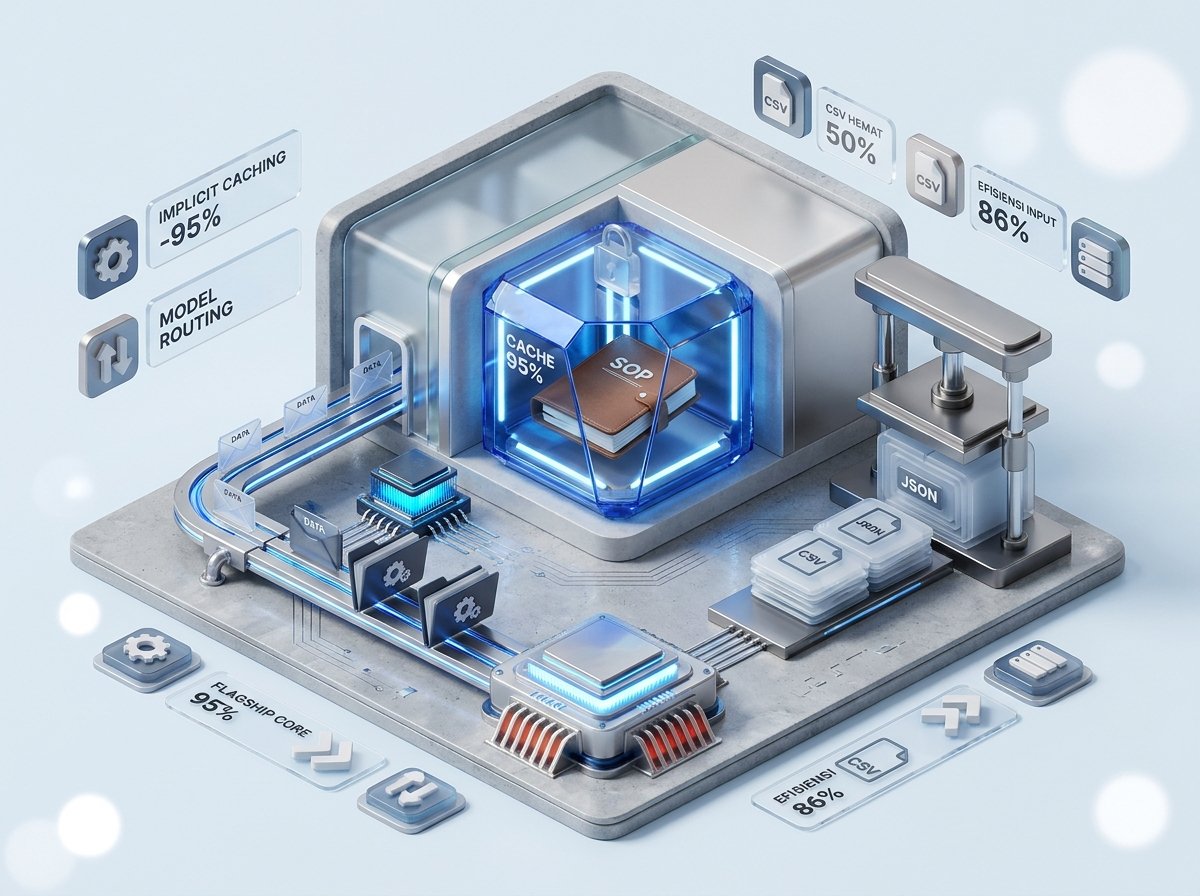
- Aktifkan Implicit Context Caching: Fitur penyimpanan otomatis potongan instruksi statis berulang di server AI ini memberi diskon biaya token input hingga 95% (misalnya pada lini Google Gemini 4 dengan ambang prefiks minimal 4.096 token), sebagaimana tercantum dalam dokumentasi resmi Google AI Studio. Letakkan seluruh panduan SOP atau dokumen rujukan di bagian paling awal prompt, lalu taruh pertanyaan dinamis di bagian akhir agar diskon berjalan otomatis.
- Terapkan model routing berjenjang: Alokasikan model kelas berat hanya untuk analisis mendalam atau penyusunan strategi kompleks. Alihkan tugas rutin seperti ekstraksi data, penyaringan pesan masuk, dan pengelompokan kata kunci ke model kelas ringan yang biayanya jauh lebih ekonomis.
- Kendalikan thinking level dan batas output: Atur tingkat penalaran ke level rendah atau menengah untuk tugas operasional harian, lalu kunci parameter batas maksimal token output. Langkah ini mencegah model menghabiskan ribuan thinking tokens bertarif mahal untuk pertanyaan sederhana.
- Kompres format data kirim: Saat mengirimkan data tabel ke dalam prompt, gunakan format CSV atau tabel Markdown daripada struktur JSON bersarang. Menghilangkan pengulangan nama kunci dan tanda kutip mampu memangkas pemakaian token sebesar 30% hingga 50% untuk data yang sama.
- Pangkas riwayat obrolan secara berkala: Mulai sesi percakapan baru setiap kali topik berganti, atau rangkum riwayat panjang secara otomatis (session pruning). Dengan begitu, aplikasi tidak terus-menerus membayar ulang token konteks lama yang sudah tidak relevan.
📊 Prinsip Efisiensi Caching 95%:
Penempatan dokumen statis minimal 4.096 token di bagian paling awal prompt memangkas tarif input berulang dari $4,00 menjadi hanya $0,20 per 1 juta token (hemat 95% pada bagian prefiks yang sama).
Mari kita lihat dampaknya pada sebuah kantor konsultan pajak dan akuntansi yang menjalankan 1.000 kueri audit per bulan dengan asumsi rasio cache hit optimal secara berkelanjutan. Setiap kueri melampirkan prefiks statis dokumen SOP sepanjang 5.000 token ditambah 500 token pertanyaan dinamis klien dengan tarif input standar $4,00 per 1 juta token.
- Sebelum menerapkan caching: Total input mencapai 1.000 × 5.500 = 5.500.000 token (5,5 juta token). Biaya input bulanan sebesar 5,5 × $4,00 = $22,00/bulan.
- Sesudah mengaktifkan Implicit Context Caching (tarif cached $0,20/1M): Hanya kueri pertama yang membayar penuh 5.000 token prefiks ditambah 500.000 token pertanyaan dinamis (total 505.000 token reguler = 0,505 × $4,00 = $2,02). Sebanyak 999 kueri sisanya masuk kategori cached (4.995.000 token = 4,995 × $0,20 = $0,999), sehingga total biaya input turun drastis menjadi $3,019 atau sekitar $3,02/bulan.
Lewat penataan urutan prompt saja, kantor konsultan tersebut menghemat $18,981/bulan (hemat 86,28%) pada pos biaya input. Pengendalian anggaran token ini menjadi fondasi penting saat perusahaan mengadopsi agen AI multi-giliran dalam alur kerja harian. Anda dapat membaca pembahasannya secara lebih menyeluruh pada panduan penerapan AI untuk bisnis.
Pengaruh Batas Token dan Context Window terhadap Konten SEO serta RAG
Banyak penulis beranggapan kapasitas context window sebesar satu juta token membuat mesin pencari AI selalu membaca seluruh artikel secara utuh. Padahal, selain menerapkan dasar optimasi mesin pencari, Anda perlu memahami cara kerja sistem Retrieval-Augmented Generation (RAG) yang menarik potongan referensi halaman web dengan anggaran konteks ketat.
Demi menjaga kecepatan respons di bawah setengah detik dan menghindari penurunan akurasi di tengah dokumen panjang (fenomena Lost in the Middle), mesin RAG menerapkan proses chunking. Halaman artikel website Anda dipotong menjadi blok-blok kecil berukuran 256, 512, hingga 1.024 token sebelum disimpan ke indeks vektor.
🎯 Patokan Estimasi Praktis Token Bahasa Indonesia:
Estimasi Token Bahasa Indonesia = Jumlah Kata × 1,8 (batas atas: × 2,0)
Sebagai catatan transparan, rumus di atas adalah patokan estimasi praktis di lapangan untuk membantu Anda menakar panjang paragraf. Rumus ini bukan hukum matematika eksak karena hasil persis selalu bergantung pada kamus tokenizer tiap model.
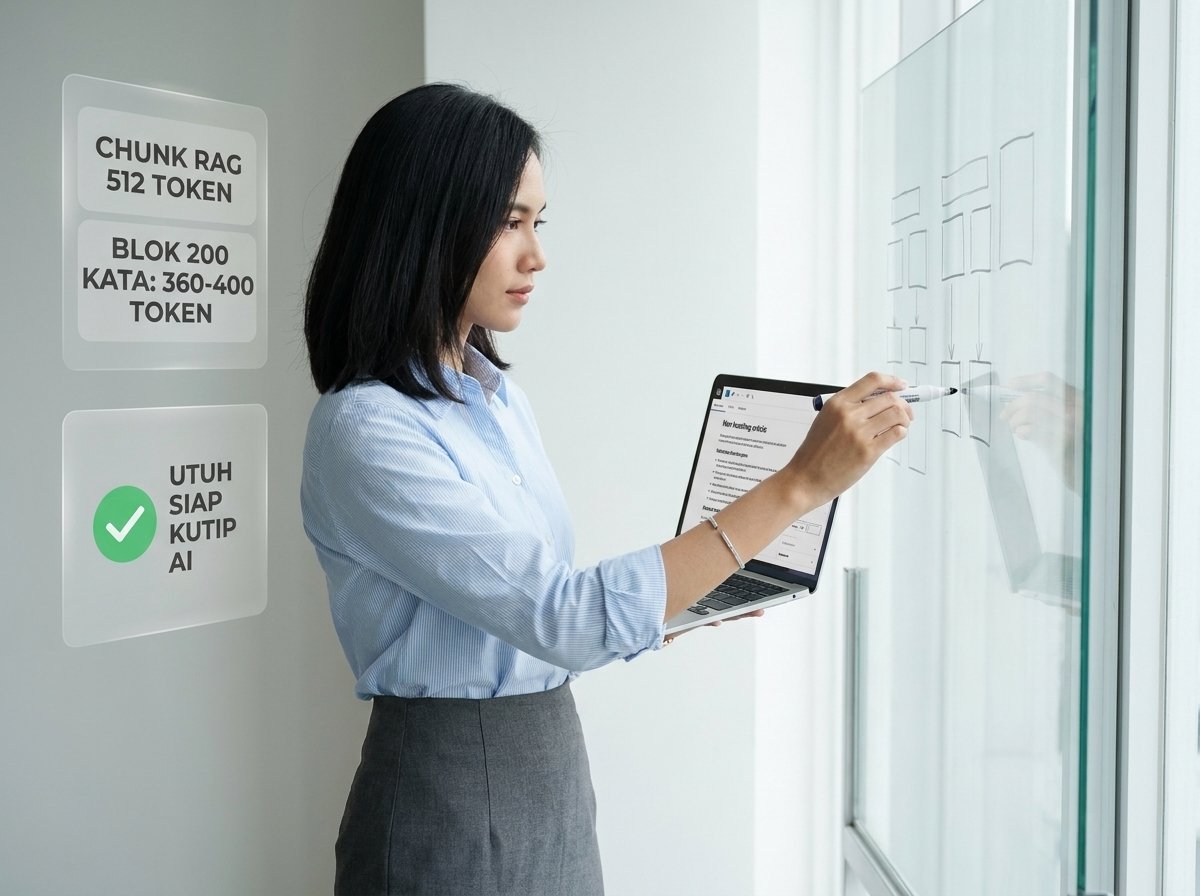
Satu potongan chunk RAG berukuran 512 token sanggup menampung sekitar 385 kata bahasa Inggris (512 ÷ 1,33), tetapi hanya memuat 256 hingga 284 kata bahasa Indonesia (512 ÷ 2,0 hingga 512 ÷ 1,8). Sebagai contoh lapangan, bandingkan hasil penataan panduan teknis material pada sebuah perusahaan distributor bahan bangunan berikut ini:
- Sub-bab 800 kata tanpa ringkasan pembuka: Blok teks ini memakan 1.440 hingga 1.600 token (800 × 1,8 hingga 2,0) sehingga terpecah menjadi tiga hingga empat potongan pada batas 512 token dan memutus detail spesifikasi penting.
- Ringkasan inti pada 200 kata pertama: Pembuka padat ini hanya mengonsumsi 360 hingga 400 token, sehingga masuk 100% utuh ke dalam satu chunk 512 token tanpa terpotong.
- Sub-bab mandiri sepanjang 350 kata: Penataan terstruktur ini menghasilkan 630 hingga 700 token yang tetap terbaca utuh pada batas chunk 1.024 token.
Disiplin pemadatan struktur blok informasi inilah yang menjadi tulang punggung strategi Generative Engine Optimization. Artikel yang langsung menyajikan fakta inti di awal paragraf jauh lebih mudah dikutip secara utuh oleh Google AI Overviews, ChatGPT Search, maupun Perplexity.
Pertanyaan Umum Seputar Token dalam AI
Berikut adalah lima jawaban ringkas atas pertanyaan paling sering muncul terkait perhitungan token, perbedaan algoritma tokenizer, hingga dampaknya pada biaya dan konten website Anda.
Menyelaraskan Struktur Konten Website agar Ramah Pembacaan AI

Memahami cara kerja token, rasio pemecahan kata bahasa Indonesia, dan batas pembacaan mesin pencari generatif membantu tim Anda mengambil dua keputusan strategis sekaligus. Anda bisa menekan pemborosan biaya API di sisi operasional sekaligus menata struktur artikel website agar setiap informasi kunci terbaca utuh tanpa terpotong di tengah jalan.
Jika perusahaan Anda ingin menghadirkan artikel mendalam dengan struktur blok informasi yang ringkas, akurat, dan siap dikutip sistem pencarian berbasis AI, Thidiweb Digi siap mendampingi proses produksinya. Anda dapat memanfaatkan layanan jasa pembuatan artikel SEO dari Thidiweb Digi untuk membangun aset konten yang kuat bagi pertumbuhan trafik organik bisnis Anda.