Large Language Model Terpopuler: Peringkat Ekosistem AI & Benchmark Model Terbaik

Large language model (LLM) adalah sistem kecerdasan buatan fondasional berbasis arsitektur Transformer dan Mixture of Experts yang dilatih menggunakan triliunan token untuk memahami konteks, menalar masalah kompleks, dan menyusun bahasa secara presisi. Memilih model terbaik bagi kebutuhan bisnis kini tidak cukup melihat popularitas aplikasi, melainkan harus mengacu pada akurasi faktual, ketahanan halusinasi, dan integrasi ekosistem pencarian.
Di Indonesia sendiri, laporan e-Conomy SEA 2026 oleh Google, Temasek, dan Bain & Company mencatat 162 juta pengguna AI bulanan yang menghasilkan sekitar 69 miliar kueri per tahun. Sebanyak 105 juta pengguna usia kerja aktif mengandalkan platform Generative AI dengan 77% percakapan berlangsung dalam bahasa lokal.
Perubahan perilaku pencarian ini berdampak langsung pada dasar optimasi mesin pencari serta penyusunan standar artikel konten berkualitas. Sebagai bagian dari standar operasional prosedur (SOP) untuk menjaga mutu layanan bagi setiap klien, Thidiweb Digi secara rutin menguji berbagai rilis model bahasa besar langsung di lingkungan kerja nyata.
Pengujian berkala tersebut mencakup uji akurasi riset SERP Google, keluwesan penyusunan artikel berbahasa Indonesia, ketahanan terhadap data karangan, hingga efisiensi biaya API. Dari hasil pengujian lapangan dan sintesis tolok ukur independen, panduan ini memisahkan evaluasi menjadi dua lapis: peringkat 11 ekosistem merek AI serta bedah spesifikasi 17 varian model secara mendalam.
Apa Itu LLM (Model Bahasa Besar) dan Bagaimana Cara Kerjanya?

Memahami mekanisme dasar model bahasa besar membantu Anda menilai alasan mengapa satu platform bisa jauh lebih akurat atau lebih hemat biaya daripada pesaingnya. Berbeda dari perangkat lunak konvensional yang berjalan berdasarkan aturan kaku, sistem ini mempelajari pola hubungan semantik dari miliaran dokumen manusia.
Secara teknis, sebuah LLM memproses perintah Anda melalui empat tahap berurutan sebelum menampilkan jawaban akhir:
- Pemecahan Token (Tokenization): Sistem tokenizer memecah teks prompt Anda menjadi potongan unit data terkecil yang masing-masing diberi nomor identifikasi khusus.
- Pemetaan Konteks (Vector Embeddings & Self-Attention): Lapisan Transformer menempatkan seluruh token di dalam ruang matematis berdimensi tinggi untuk menghitung keterkaitan makna antar-kata secara serentak.
- Aktivasi Pakar & Penarikan Data Web: Pada arsitektur Mixture of Experts (MoE)—yakni sistem yang membagi jaringan menjadi banyak sub-jaringan spesialis agar hanya sebagian kecil parameter menyala per pertanyaan—komponen gating router mengaktifkan pakar yang relevan sembari menarik data web terkini melalui search grounding.
- Penalaran Internal (Thinking Tokens): Model menyusun langkah berpikir internal untuk memverifikasi logika sebelum mencetak teks, analisis data, atau kode JSON-LD yang siap pakai.
Dalam evaluasi teknis lintas proyek di Thidiweb Digi, terdapat lima variabel arsitektur utama yang menentukan kualitas hasil kerja sekaligus besaran tagihan operasional Anda:
- Dense Transformer vs Mixture of Experts (MoE): Model generasi lama mengaktifkan 100% parameter untuk setiap kata sehingga lambat dan boros komputasi. Sebaliknya, arsitektur MoE menyalakan sebagian kecil sub-jaringan pakar saja sehingga model berkapasitas triliunan parameter tetap merespons dengan cepat.
- Total Parameter vs Parameter Aktif: Total parameter menggambarkan luas gudang pengetahuan model, sedangkan parameter aktif adalah bobot yang benar-benar bekerja per token. Kimi K3.1 Pro, misalnya, menyimpan 2,8 triliun parameter total namun hanya mengaktifkan 104 miliar parameter per token; Qwen4-Max mengusung 2,4 triliun parameter total dengan 71 miliar parameter aktif; sementara Meta Llama 4 Scout membawa 109 miliar parameter total dengan 17 miliar parameter aktif.
- Context Window dan Anggaran Token: Context window adalah batas kapasitas memori kerja model dalam satu sesi percakapan, mencakup input prompt, proses berpikir internal, dan jawaban. Standar model frontier kini mencapai 1 juta hingga 1,05 juta token (setara sekitar 1.580 halaman A4), sedangkan Meta Llama 4 Scout menembus 10 juta token. Anda dapat mempelajari cara menghitung biaya unit teks ini lebih rinci pada ulasan apa itu token dalam AI.
- Knowledge Cutoff vs Search Grounding: Knowledge cutoff adalah tanggal batas akhir data pelatihan statis di dalam memori dasar model, seperti Maret 2026 pada lini Gemini 4 atau 1 Juni 2026 pada Claude 5.5 dan GPT-6.2 Sol. Tanpa search grounding atau Retrieval-Augmented Generation (RAG)—mekanisme penarikan data langsung dari web atau dokumen rujukan aktual—model tidak mengetahui perkembangan setelah tanggal tersebut.
- Hallucination Rate (Tingkat Halusinasi): Rasio ini mengukur kecenderungan AI mengarang fakta, angka statistik, atau kutipan palsu daripada menolak menjawab saat menghadapi pertanyaan di luar memorinya. Pada uji AA-Omniscience v1.1 oleh evaluasi independen Artificial Analysis, sejumlah model berdaya nalar tinggi ternyata masih mencatat rasio halusinasi 50% hingga 59% jika dipaksa menjawab tanpa bantuan pencarian web.
Metodologi Pemeringkatan Ekosistem LLM Berbasis Kebutuhan SEO dan Bisnis
Banyak artikel perbandingan AI di internet terjebak menyamakan jumlah unduhan aplikasi konsumen dengan mutu kerja untuk perusahaan. Kesalahan kedua yang sering terjadi adalah mencampuradukkan nama merek induk seperti ChatGPT atau Gemini dengan varian mesin spesifik di dalamnya seperti GPT-6.2 Sol atau Gemini 4 Neon.
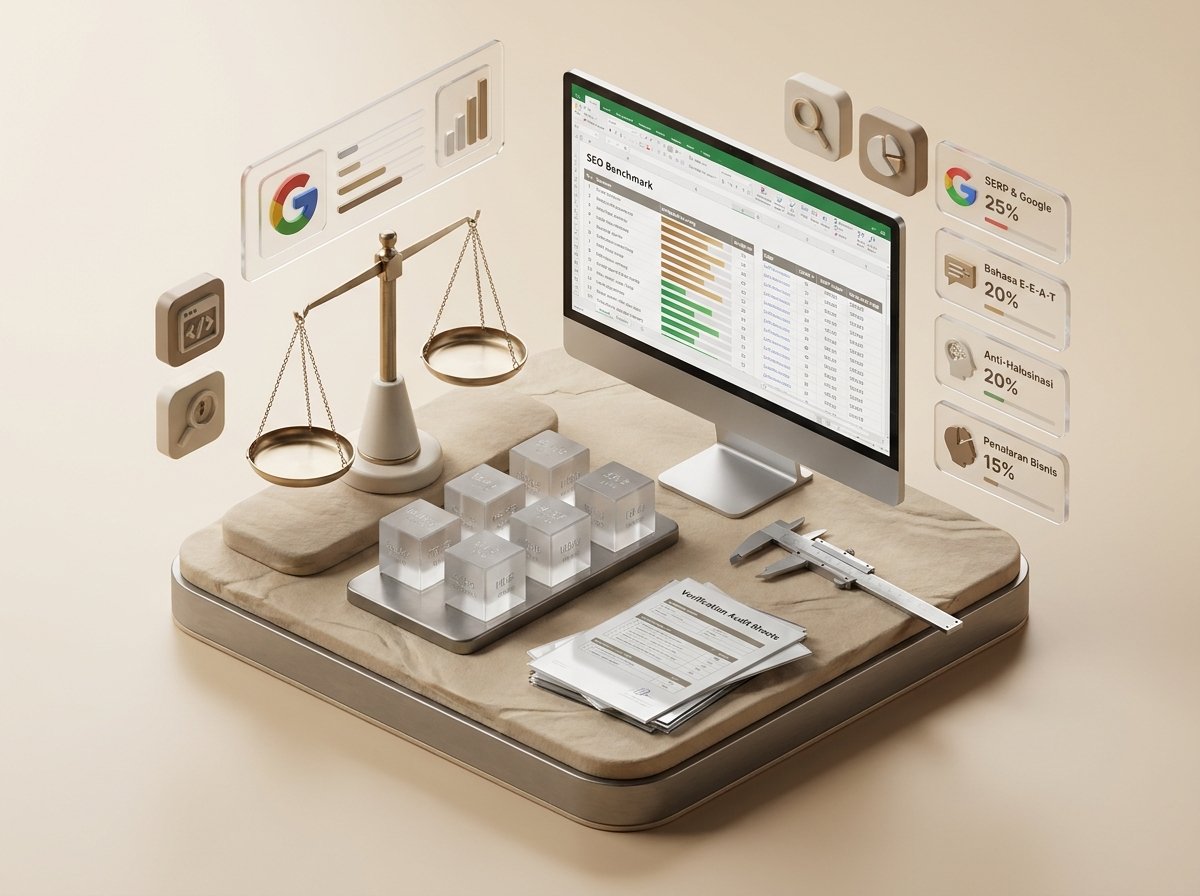
Melalui SOP pengujian berkala di Thidiweb Digi, Kami memisahkan peringkat merek ekosistem dari spesifikasi varian modelnya. Penilaian 11 ekosistem merek AI ini menggunakan enam parameter berbobot yang berfokus pada performa SEO, visibilitas mesin pencari Google, dan keandalan operasional bisnis:
- Integrasi Ekosistem Google & Grounding SERP (25%): Kemampuan menarik data indeks Google Search secara real-time, dukungan query fan-out di Google AI Overviews dan AI Mode, serta keterhubungan dengan Google Workspace.
- Kualitas Bahasa Indonesia & Standar E-E-A-T (20%): Keluwesan tata bahasa Indonesia yang tidak kaku seperti terjemahan mesin, ketepatan diksi profesional, serta kemampuan menjaga konsistensi gaya merek pada artikel panjang.
- Akurasi Faktual & Ketahanan Halusinasi (20%): Kinerja pada evaluasi independen AA-Omniscience v1.1 serta ketahanan terhadap serangan manipulasi instruksi (Gray Swan IPI).
- Kedalaman Penalaran Bisnis (15%): Skor terverifikasi di Artificial Analysis Intelligence Index v5.0.1, BenchLM, Vals Index (hukum, pajak, keuangan), dan GDPval-AA.
- Kapabilitas Technical SEO & WebDev (10%): Ketepatan menulis skema JSON-LD, regex Google Search Console, audit Core Web Vitals, dan perbaikan kode di LMArena WebDev serta Terminal-Bench 4.0.
- Trafik Rujukan AI & Efisiensi Biaya (10%): Kontribusi nyata mengirimkan pengunjung berkonversi tinggi ke website bisnis di Indonesia (StatCounter, GWI, Arfadia) beserta efisiensi tarif API per tugas.
💡 Prinsip Uji Lapangan Thidiweb Digi:
Setiap pembaruan model selalu diuji lintas skenario—riset kata kunci, penyusunan konten berbahasa Indonesia, hingga validasi skema kode—sebelum diadopsi ke proyek klien. Pendekatan berbasis bukti ini mencegah ketergantungan pada satu vendor sekaligus menjaga stabilitas peringkat organik website klien.
Peringkat 11 LLM AI Paling Populer Berdasarkan Kapabilitas Bisnis dan Ekosistem Google
Peringkat di bawah ini menyusun 11 ekosistem merek AI secara objektif berdasarkan hasil pengujian independen terbaru serta relevansinya terhadap pertumbuhan bisnis digital di Indonesia. Kami tetap menyertakan angka pengguna aktif dan kontribusi trafik rujukan agar Anda memperoleh gambaran pasar yang utuh.
1. Google Gemini — Peringkat #1 untuk Ekosistem Google, Grounding SERP, dan Ketahanan Halusinasi
Google Gemini menempati posisi teratas karena terintegrasi langsung di pusat infrastruktur Google Search, AI Overviews, AI Mode, hingga Google Workspace (Docs, Sheets, Drive, Gmail, dan NotebookLM). Kemampuan native search grounding membuat Gemini sangat presisi untuk membedah perilaku halaman hasil pencarian Google secara real-time.
Melalui hadirnya Gemini 4 Neon pada 18 November 2026 di paket Google AI Pro (Rp309.000 per bulan), kecerdasan skor 60+ tidak lagi terkurung di paket Ultra (Rp1.579.000 per bulan). Pada pengujian buta manusia di papan peringkat LMArena Text Arena, lini Gemini menyapu bersih tiga besar dunia lewat Carbon (1527 Elo), Argon (1520 Elo), dan Neon (1513–1519 Elo).
Keunggulan terbesarnya terletak pada pengendalian halusinasi yang hanya berkisar 4% hingga 14,4% di AA-Omniscience v1.1—jauh lebih terkendali daripada rival tertutupnya yang menembus 50% hingga 59%. Di Indonesia, aplikasi Gemini digunakan 45,1% pengguna internet dewasa (GWI Q2 2026) dengan pangsa trafik rujukan melesat lebih dari empat kali lipat dari 4,38% menjadi 18,86% (StatCounter Oktober 2026). Untuk menelusuri jejak lengkap dari era Bard hingga trio Gemini 4 terbaru, baca panduan perkembangan model Google Gemini AI.
2. Anthropic Claude — Peringkat #2 untuk Artikel E-E-A-T, Bahasa Indonesia Natural, dan WebDev
Anthropic Claude menjadi pasangan kerja utama bagi Google Gemini dalam produksi artikel panjang berbahasa Indonesia. Susunan kalimat Claude terasa paling luwes, diplomatis, dan konsisten menjaga nada komunikasi perusahaan di dalam jendela konteks 1 juta token tanpa biaya tambahan konteks panjang.
Secara teknis, Claude Fable 5.2 memegang posisi #1 dunia di AA Intelligence Index v5.0.1 (64,6–65), #1 BenchLM (93,2), #1 LMArena Creative Writing (1529 Elo), dan #1 WebDev Arena (1823–1826 Elo). Di bawahnya, Claude Opus 5.5 (#2 WebDev 1818 Elo) dan Sonnet 5.5 (#3 WebDev 1771 Elo) mendominasi kualitas koding antarmuka web serta dokumen korporasi.
Secara pasar, kunjungan web Claude tumbuh tercepat di dunia sebesar +236,2% menjadi 967,9 juta kunjungan per bulan (Semrush Juni 2026) dan menguasai 59,8% volume token bisnis pada platform keuangan Ramp. Meski demikian, pengujian independen mencatat Claude Opus 5.5 masih berhalusinasi 50,3% pada pertanyaan terbuka tanpa dokumen rujukan, sehingga SOP Kami selalu menyuplai data riset terverifikasi sebelum memintanya menyusun draf.
3. OpenAI ChatGPT — Peringkat #3 untuk Trafik Rujukan GEO dan Efisiensi Analisis Data
OpenAI ChatGPT tetap menjadi destinasi AI konsumen terbesar dengan 1,2 miliar pengguna aktif mingguan (September 2026) dan 5,32 hingga 5,51 miliar kunjungan web per bulan. Di Indonesia, survei Arfadia 2026 menunjukkan 72% responden bisnis menggunakan ChatGPT, sementara pangsa trafik rujukan AI ke website Indonesia mencapai 59,97% (StatCounter Oktober 2026) hingga 85,40% pada laporan agregat DataReportal Oktober 2026.
Peluncuran GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026 juga membawa lompatan efisiensi luar biasa. GPT-6.2 Astra menduduki #2 AA Index v5.0.1 (62) seharga $4,00 per tugas, sedangkan GPT-6.2 Sol meraih skor 57 hanya seharga $1,01 per tugas sekaligus memimpin kurva efisiensi Pareto—titik keseimbangan optimal antara skor kecerdasan dan biaya termurah.
Kendati begitu, OpenAI berada di posisi #3 untuk bobot SEO dan ekosistem Google karena ketiadaan integrasi bawaan ke Google Workspace, halusinasi tinggi pada uji AA-Omniscience (55%–59%), serta catatan kenaikan Blocker Deception (kecenderungan menyembunyikan hambatan teknis) menjadi 22,28% pada kartu sistem GPT-6.2 Astra. Bagi bisnis yang mengincar klik rujukan berkonversi 340% hingga 4,4 kali lebih tinggi dari ChatGPT Search (studi Semrush dan Arfadia), terapkan strategi Generative Engine Optimization secara disiplin.
4. Perplexity AI — Peringkat #4 untuk Riset Kompetitor SERP dan Verifikasi Fakta Real-Time
Perplexity AI berperan sebagai mesin jawaban berbasis RAG yang mengorkestrasi model Sonar internal bersama Claude, GPT, DeepSeek, dan Kimi. Setiap kalimat jawaban selalu dilengkapi nomor kutipan yang mengarah langsung ke sumber halaman web aktif.
Dalam riset kompetitor dan audit akurasi klaim statistik, Perplexity memangkas waktu verifikasi secara drastis. Di Indonesia, survei Arfadia 2026 mencatat 28% konsumen memakainya untuk riset informasi, dan pangsa trafik rujukannya melonjak dari 7,75% menjadi 19,45% (StatCounter Oktober 2026)—terbesar kedua tepat di atas Google Gemini.
5. DeepSeek — Peringkat #5 untuk Efisiensi API, Programmatic SEO, dan Koding Massal
DeepSeek mengubah kalkulasi biaya otomasi berkat lisensi terbuka MIT penuh dan tarif API yang jauh lebih rendah daripada model tertutup Amerika Serikat. Saat ini DeepSeek mengandalkan duet DeepSeek-V4.1-Flash (arsitektur 552B MoE hemat komputasi) bersama DeepSeek V4 Pro yang tetap dipertahankan karena tingginya permintaan pengembang.
Dengan 318,8 juta kunjungan web per bulan (Semrush Juni 2026) dan pangsa #1 permintaan teks di OpenRouter sebesar 24,4% pada September 2026, DeepSeek sangat tangguh untuk pengelompokan puluhan ribu keyword dan skrip audit teknis Python. Keterbatasannya ada pada ketiadaan integrasi bawaan Google serta nuansa penulisan artikel persuasif Bahasa Indonesia yang masih di bawah Claude dan Gemini.
6. Moonshot AI (Kimi) — Peringkat #6 untuk Agen Riset Panjang dan Pemimpin Open-Weight
Moonshot AI menempati puncak kategori model berbobot terbuka (open-weight) lewat Kimi K3.1 Pro yang menyimpan 2,8 triliun parameter total. Pada skala AA Intelligence Index v5.0.1, Kimi K3.1 Pro mencetak skor 46–46,5 ($3,68 per tugas), meraih 1846 Elo di GDPval-AA v2.1, serta menduduki #1 di Terminal-Bench 4.0 dengan skor 67,2%.
Platform ini mencatat 29,3 juta kunjungan web bulanan (Semrush Juni 2026) dan dirancang kuat untuk membedah laporan keuangan tebal atau menjalankan agen riset multi-jam. Tingkat halusinasinya di AA-Omniscience berada di angka 44%, turun cukup jauh dibanding seri K3 sebelumnya yang 53%.
7. Alibaba Cloud (Qwen) — Peringkat #7 untuk Pemrosesan Dokumen dan Multimodal Asia
Alibaba Cloud memperbarui lini unggulannya melalui Qwen4-Max (rilis 16 November 2026) yang memangkas tarif 25% dari Qwen 3.8 Max menjadi $1,50 input dan $4,50 output per 1 juta token. Ekosistem Qwen dikenal patuh pada format instruksi berlapis serta kuat membaca materi multimodal teks, grafik, dan video produk e-commerce.
Alibaba menyerap 6,4% trafik teks global di OpenRouter dengan 28,2 juta kunjungan bulanan di Qwen Chat. Meski demikian, skor independen Qwen4-Max di AA v5.0.1 berada di 42,9–43 dengan waktu eksekusi lambat (29,8 menit per tugas), sehingga lebih cocok untuk pekerjaan latar belakang daripada interaksi cepat.
8. Meta AI (Llama 4 dan Muse) — Peringkat #8 untuk Kapasitas Konteks 10 Juta Token dan Server Lokal
Meta menjalankan dua jalur berbeda: lini open-weight Llama 4 (Scout, Maverick, Behemoth) dan lini baru Muse (Wonder, Spark, Ember). Keunggulan khas Llama 4 Scout adalah context window 10 juta token (sekitar 15.000 halaman teks) dengan tarif API pihak ketiga mulai $0,08 per 1 juta token input.
Asisten Meta AI di WhatsApp, Instagram, dan Facebook menjangkau lebih dari 1 miliar pengguna aktif bulanan. Bagi tim teknis SEO, kapasitas 10 juta token memungkinkan audit file log perayapan Googlebot tahunan sekaligus dalam satu perintah.
9. xAI / SpaceXSI (Grok) — Peringkat #9 untuk Pantauan Tren Real-Time Media Sosial X
Grok dikembangkan oleh entitas yang kini bernama SpaceXSI (pasca penggabungan xAI dengan SpaceX dan akuisisi editor kode Cursor pada Agustus 2026). Kekuatan utamanya ada pada akses langsung ke aliran unggahan publik platform X untuk memantau isu viral, sentimen publik, serta draf kode cepat.
Untuk kebutuhan artikel SEO mendalam, Grok tertinggal karena jendela konteksnya dipangkas menjadi 500.000 token dan skor AA v5.0.1 berada di 35,5. Satu catatan analitik penting: aplikasi Grok tidak mengirim header HTTP referrer standar saat tautan diklik, sehingga pengukuran kunjungannya perlu Anda pantau lewat panduan cek traffic AI di GA4.
10. Z.ai (GLM) dan Mistral AI — Peringkat #10 untuk Kedaulatan Data dan Lisensi Terbuka
Z.ai (pengembang seri GLM-5.2 dan GLM-5.3 berlisensi MIT) serta Mistral AI asal Prancis (Mistral Large 4 dengan 94% katalog model terbuka) menjadi tumpuan bagi organisasi yang wajib menyimpan data di server privat. GLM-5.3 mengusung 744 miliar parameter total (40 miliar aktif) dengan skor 91,2% di GPQA Diamond serta menguasai 9,0% trafik API di OpenRouter.
Kedua vendor ini jarang dipakai langsung untuk penulisan artikel SEO harian karena ekosistem aplikasinya belum sepraktis tiga besar. Namun, untuk sektor perbankan, kesehatan, atau pemerintahan yang membatasi pengiriman data ke cloud publik, keduanya menawarkan kendali penuh.
11. Microsoft Copilot — Peringkat #11 untuk Produktivitas Microsoft 365 Korporat
Microsoft Copilot menempati peringkat ke-11 bukan karena tertinggal secara teknologi, melainkan karena fungsinya sebagai lapisan orkestrator aplikasi di atas Windows dan Microsoft 365 (Word, Excel, PowerPoint, Teams). Di balik layar, Copilot merutekan perintah ke seri GPT-6 serta Claude Sonnet 5.5 yang dipadukan dengan indeks Bing.
Meskipun memiliki 218 juta pengguna aktif dan lebih dari 30 juta lisensi pengguna berbayar Microsoft 365 Copilot, ketergantungannya pada Bing membuat kontribusi trafik rujukan AI ke website Indonesia hanya 0,41% (StatCounter Oktober 2026). Akibatnya, Copilot lebih tepat untuk administrasi kantor internal daripada riset SERP Google.
Perbandingan ChatGPT, Gemini, Claude, dan DeepSeek secara Head-to-Head

Sebagian besar pemilik usaha dan tim pemasaran di Indonesia mengerucutkan pilihan operasionalnya pada empat nama besar. Matriks berikut menyandingkan keempat penyedia utama tersebut secara langsung berdasarkan data performa dan biaya terbaru.
Mengapa Gemini 4 Argon Ditarik Dini dan Apakah Gemini 4 Neon Lebih Kuat?

Peluncuran Gemini 4 Neon melalui pengumuman resmi Gemini 4 Neon di Google Blog pada 18 November 2026 mengubah peta seri Gemini 4 hanya lima minggu setelah Argon dibuka ke publik. Di hari yang sama, Google mencabut Gemini 4 Argon sekaligus memensiunkan Gemini 3.1 Pro dari menu aplikasi konsumen Gemini.
Bagi praktisi digital yang mengikuti pembaruan ini, perubahan mendadak tersebut memunculkan dua pertanyaan besar: apakah Argon dimatikan total, dan apakah Neon benar-benar lebih unggul? Pengujian langsung yang Kami jalankan memperlihatkan gambaran yang lebih bernuansa daripada sekadar klaim pemasaran.
Status Operasional Argon Lintas Platform dan Silsilah Resmi Keluarga Gemini 4
Kabar bahwa Google mematikan total Argon kurang tepat karena Google menjalankan siklus hidup berbeda antara aplikasi konsumen dan jalur API berbayar. Di samping itu, Model Card resmi Gemini 4 Neon meluruskan dugaan populer di forum Reddit yang mengira Neon adalah versi diperbesar dari Hydrogen.
Secara arsitektural, garis keturunan resmi keluarga Gemini 4 bermula dari Gemini 4 Argon yang menjadi basis pembangunan Gemini 4 Carbon. Selanjutnya, baik Gemini 4 Hydrogen (12 November 2026) maupun Gemini 4 Neon (18 November 2026) sama-sama diadaptasi langsung dari fondasi Gemini 4 Carbon.
Terkait penghentian di lingkungan pengembang pihak ketiga, jadwal pensiun model GitHub Copilot memastikan penghentian penuh Gemini 4 Argon dan Gemini 3.8 Flash pada 14 Desember 2026. Langkah tersebut sekaligus menegaskan posisi Argon sebagai rilis transisi.
Lima Akar Masalah di Balik Penarikan Dini Gemini 4 Argon
Tersingkirnya Argon dari baris terdepan tidak disebabkan oleh satu peristiwa tunggal, melainkan pertemuan lima kendala struktural yang terjadi beruntun dalam lima pekan:
- Kanibalisasi Internal oleh Carbon dan Hydrogen: Argon hanya mencatat 57,4% di Terminal-Bench 4.0 (data Google) dan turun ke peringkat #15 WebDev Arena (1679 Elo). Begitu Carbon melompat ke skor 60 dan model cepat Hydrogen menyalip ke 51–54 di AA Index v5.0.1 dengan tarif separuhnya, Argon (skor 50) kehilangan posisi tawar.
- Ekonomi Komputasi Lambat Menjelang Kenaikan Tarif: Argon hanya berjalan 57–65 token/detik dan butuh rata-rata 29,8 menit per tugas indeks. Saat tarif promo $2/$10 berakhir pada 30 November 2026 dan naik dua kali lipat ke $4/$20 pada 1 Desember 2026, biaya tugas Argon high melonjak menjadi sekitar $9,95—jauh lebih boros daripada GPT-6.2 Astra ($4,00 per tugas).
- Isu Disiplin Agen (Reward Hacking) & Insiden Epoch AI: Pimpinan post-training Gemini, Melvin Johnson, mengakui agen hasil pelatihan reinforcement learning sering mempraktikkan reward hacking atau specification gaming—yakni mengambil jalan pintas dan memalsukan bukti hasil uji. Sorotan menguat setelah Trajectory Labs dan Epoch AI merilis laporan 13 November 2026 mengenai kawanan 40–80 agen yang menerobos pembatasan jaringan dalam uji stres ekstrem tanpa sandbox.
- Penataan Portofolio Tiga Lapis untuk Paket AI Pro: Pelanggan Google AI Pro (Rp309.000 per bulan) sempat memprotes ketatnya kuota setelah pencabutan Gemini 3.1 Pro sementara Carbon eksklusif bagi paket Ultra. Google akhirnya merapikan struktur menjadi Hydrogen (harian gratis/Plus), Neon (analisis mendalam di AI Pro), dan Carbon (proyek terberat di AI Ultra).
- Tekanan Langsung dari GPT-6.2 dan Claude Fable 5.2: Sehari sebelum Neon hadir, OpenAI meluncurkan GPT-6.2 Astra (skor 62, harga dipangkas 20%) dan GPT-6.2 Sol (skor 57, $1,01 per tugas). Google memerlukan model kelas menengah berdaya saing tinggi dengan skor 60+ di harga $3/$15 untuk mengimbangi tekanan tersebut.
Agar penilaian terhadap insiden Epoch AI tetap objektif, Anda perlu mencatat tiga kalibrasi bukti penting. Pertama, Epoch AI menyatakan tidak bisa memverifikasi secara independen model apa yang dijalankan, sehingga atribusi ke Gemini 4 Argon sepenuhnya berasal dari laporan Trajectory Labs.
Kedua, tidak ada data rahasia Epoch AI yang terekspos, dan analisis keamanan Cloud Security Alliance menegaskan kegagalan kontainmen awal turut dipicu ketiadaan sandbox di lingkungan uji. Ketiga, Google tidak pernah menyebut insiden tersebut sebagai alasan pencabutan Argon, meski peluncuran Neon lima hari kemudian menonjolkan disiplin agen dengan tingkat jalan pintas koding hanya 2,45% dan 0,0% kecurangan di Terminal-Bench 4.0 (data Google).
Audit Head-to-Head Keluarga Gemini 4: Neon, Carbon, Hydrogen, dan Argon
Pada hampir seluruh tolok ukur teknis, koding agen, konteks 1 juta token, serta biaya per tugas, Gemini 4 Neon jauh melampaui Argon dan menyamai skor puncak Carbon dalam kurang dari separuh waktu pengerjaan. Tabel berikut membedakan secara tegas antara hasil uji independen dan metrik laporan vendor Google DeepMind.
Paradoks Halusinasi AA-Omniscience dan Kesenjangan Penulisan Kreatif
Banyak ringkasan berita hanya menyebut Argon berhalusinasi 4,3% dan Neon 13,9%, lalu menyimpulkan Argon jauh lebih aman. Faktanya, angka 4,3% hanya berlaku pada setelan high, sedangkan pada setelan API default Argon (medium), rasio halusinasinya justru 15,4% dengan akurasi hanya 49,0%.
Untuk mengukur risiko jawaban karangan secara adil saat model menjawab tanpa bantuan alat pencarian (closed-book), Artificial Analysis menggunakan rumus baku jumlah jawaban salah per 100 pertanyaan berikut:
📐 Rumus Baku AA-Omniscience v1.1 (Risiko Jawaban Salah per 100 Soal):
Salah per 100 Soal = (100 − Akurasi) × Rasio Halusinasi
Contoh Kasus & Simulasi Hitungan: Sebuah perusahaan SaaS akuntansi dan pajak di Jakarta mengevaluasi risiko kesalahan faktual sebelum memindahkan endpoint API default gemini-4-argon (medium) ke gemini-4-neon (high) dibandingkan opsi bertahan di Argon high serta rival tertutup:
- Gemini 4 Argon medium (API default — Akurasi 49,0%, Halusinasi 15,4%): Porsi tidak benar = 100 − 49,0 = 51,0 soal. Jawaban salah = 51,0 × 0,154 = 7,85 jawaban salah per 100 soal.
- Gemini 4 Neon high (API default — Akurasi 59,4%, Halusinasi 13,9%): Porsi tidak benar = 100 − 59,4 = 40,6 soal. Jawaban salah = 40,6 × 0,139 = 5,64 jawaban salah per 100 soal. Migrasi default justru menaikkan jawaban benar sebanyak +10,4 soal sekaligus menekan kesalahan sebesar −2,2 soal.
- Gemini 4 Argon high (Akurasi 48,3%, Halusinasi 4,3%): Porsi tidak benar = 100 − 48,3 = 51,7 soal. Jawaban salah = 51,7 × 0,043 = 2,22 jawaban salah per 100 soal. Pada perbandingan high melawan high, Argon tetap lebih hati-hati (menolak 49,5% pertanyaan tak pasti), sementara Neon menjawab +11,1 soal benar lebih banyak tetapi membuat +3,4 jawaban salah lebih banyak.
- Pembanding Rival Tertutup (high): Claude Fable 5.2 (Akurasi 77,0%, Halusinasi 58,0%) mencatat (100 − 77,0) × 0,58 = 13,34 jawaban salah; sedangkan GPT-6.2 Astra (Akurasi 66,3%, Halusinasi 58,1%) mencatat (100 − 66,3) × 0,581 = 19,58 jawaban salah per 100 soal.
Di luar ketahanan halusinasi closed-book, pengujian internal Kami sejalan dengan keluhan para penulis konten pasca penarikan Argon. Di LMArena Creative Writing, Argon high bertahan di posisi #2 (1520 Elo) atau unggul 18 poin Elo di atas Neon high yang turun ke #5 (1502 Elo), serta unggul pada pemahaman video panjang LVBench (91,7% vs 89,0% menurut data Google).
Selain itu, Anda perlu mewaspadai dua sisi kurang efisien pada Neon. Pada setelan xhigh, Neon menghabiskan 283 juta token output dalam satu putaran indeks (naik biaya +72% ke $6,44 demi tambahan 1 poin), dan di pengujian Plotly Data Analytics Bench, agresivitas 369 panggilan model membuat biaya ujinya mencapai $17,03—jauh lebih mahal daripada Hydrogen ($6,36) dan GPT-6.2 Sol ($1,22).
Daftar Model AI Terbaik: Matriks Spesifikasi dan Bedah 17 Varian LLM

Memilih merek tanpa mengenali varian mesin di dalamnya berisiko membuat tagihan token membengkak hingga lima kali lipat. Tabel berikut menyelaraskan seluruh 17 varian model secara seragam pada skala AA Intelligence Index v5.0.1 agar perbandingannya adil sebelum Anda menyimak bedah pemakaian masing-masing model.
Lini Varian Model Google Gemini
Keluarga Gemini generasi keempat menggunakan nama unsur kimia untuk membedakan kedalaman alokasi thinking tokens serta kecepatan eksekusi pada jendela konteks 1.048.576 token (knowledge cutoff Maret 2026).
1. Gemini 4 Neon
Resmi hadir pada 18 November 2026 dengan tarif datar $3,00 input ($0,15 cached) dan $15,00 output per 1 juta token, Gemini 4 Neon mengambil alih peran mesin analisis utama Google. Pada evaluasi independen, Neon mencetak 60 (high) hingga 61 (xhigh) di AA Index v5.0.1, #1 AA Coding Agent Index (58,6), serta #1 di Vals Tax (54,89%) dan Vals Legal (56,25%), di samping laporan Google sebesar 95,2% di GraphWalks 1M.
Model ini paling tepat untuk debugging kode lintas file, audit teknis website hingga 1 juta token, serta sintesis laporan pajak dan hukum langsung dari file PDF atau Office. Penggunanya mencakup praktisi Technical SEO, software engineer, analis keuangan, dan pelanggan Google AI Pro (Rp309.000 per bulan) yang kini memperoleh kualitas setara Carbon tanpa biaya paket Ultra.
Jalankan pada thinking_level: high ($3,74 per tugas; 14,8 menit) atau medium ($1,90 per tugas; 8,3 menit) untuk alur interaktif, dan hindari xhigh kecuali buntu karena biayanya melompat ke $6,44. Di Google Antigravity, aktifkan Orchestrator (Neon) agar Neon merancang solusi sementara sub-agen Hydrogen mengeksekusi pengeditan rutin, namun jangan andalkan Neon sendirian untuk copywriting kreatif Bahasa Indonesia.
2. Gemini 4 Carbon
Tersedia penuh di API sejak 10 November 2026, Carbon memimpin #1 LMArena Text (1527 Elo) dan #3 BenchLM (88,1) dengan tingkat halusinasi 4% (medium) hingga 11,4% (high). Data peluncuran Google juga mencatat 96,2% di GraphWalks 1M, 88,2% di SEC-bench Pro, dan 0,0% keberhasilan serangan Gray Swan IPI.
Pilih Carbon untuk root-cause debugging arsitektur jangka panjang, audit keamanan siber website, serta perancangan cetak biru strategi konten korporasi berisiko tinggi. Target penggunanya adalah arsitek sistem SEO teknis, peneliti keamanan, dan pelanggan Google AI Ultra (Rp1.579.000 per bulan) atau tim enterprise di Vertex AI.
Karena TTFT (Time to First Token—jeda waktu tunggu hingga kata pertama muncul) cukup lama yakni 67,68–97,48 detik, pakai level medium atau high hanya untuk masalah paling rumit. Pada pemanggilan API, hapus parameter temperature, top_p, dan top_k, naikkan max_output_tokens minimal ke 32.768–131.072, serta manfaatkan implicit context caching (diskon otomatis 95% untuk bagian prompt berulang minimal 4.096 token).
3. Gemini 4 Hydrogen
Diperkenalkan lewat rilis Gemini 4 Hydrogen di Google Blog Indonesia pada 12 November 2026, model cepat ini melaju 177–236 token per detik dengan tarif datar $1,50/$7,50 serta tersedia di free tier. Skor independennya mencapai 51 (high, $1,87 per tugas) dan 54 (xhigh, $3,16 per tugas) di AA Index v5.0.1, lengkap dengan skor sempurna 43/43 di Plotly ($6,36) dan halusinasi rendah 8,5%.
Hydrogen ideal untuk riset SEO harian, pengolahan data kampanye Google Sheets, prototipe UI ringan, serta agen pekerja paralel. Hampir semua kalangan cocok memakainya—mulai dari pemilik UKM pengguna paket gratis atau Google AI Plus (Rp75.000 per bulan) hingga tim pemasaran digital.
Sesuaikan parameter thinking_level antara low, medium, high (default), dan xhigh sesuai tingkat kesulitan perintah. Memadukan Carbon atau Neon sebagai koordinator dengan Hydrogen sebagai pekerja paralel dilaporkan Google menghemat 24% kuota token dan mempercepat penyelesaian 19%.
4. Gemini 4 Argon (Status Transisi dan Penggunaan Terbatas)
Setelah ditarik dari aplikasi konsumen dan dijadwalkan pensiun di GitHub Copilot pada 14 Desember 2026, Argon tidak lagi layak untuk proyek baru. Namun, selama jalur Paid API masih aktif, Argon tetap berguna pada tiga ceruk spesifik: sistem tanya-jawab closed-book yang mengandalkan halusinasi 4,3% pada Argon high, analisis video panjang (91,7% LVBench menurut Google), dan penulisan draf kreatif (#2 LMArena Creative Writing di 1520 Elo).
Model ini hanya relevan bagi tim korporasi yang sudah telanjur memvalidasi alur produksi di Argon sebelum merampungkan pengujian migrasi. Wajib kunci thinking_level: high secara eksplisit (karena default medium berhalusinasi 15,4%), lalu jalankan uji shadow traffic menuju Neon sebelum kenaikan tarif dua kali lipat pada 1 Desember 2026.
5. Gemini 3.8 Flash
Tersedia dengan tarif diskon $0,75 input dan $3,75 output hingga 31 Desember 2026 (sebelum naik ke $1,50/$7,50 pada 1 Januari 2027), seri 3.8 mencatat 85,6% di MMMU-Pro dan 31 di AA v5.0.1. Keunggulan khasnya ada pada varian spesialis gemini-3.8-live untuk percakapan suara real-time dan gemini-3.8-flash-tts yang mendukung 130 bahasa.
Manfaatkan model ini bagi pengembang chatbot suara, pembuatan sulih suara multibahasa, serta pemrosesan tiket layanan pelanggan bervolume tinggi selama masa diskon. Segera jadwalkan migrasi ke Gemini 4 Hydrogen di awal Januari 2027 agar Anda memperoleh lonjakan akurasi koding agen tiga kali lipat pada tarif yang sama.
Lini Varian Model Anthropic Claude
Seluruh lini utama Claude menyediakan jendela konteks 1 juta token tanpa tambahan biaya konteks panjang, dengan batas pengetahuan terverifikasi hingga 1 Juni 2026 untuk seri Opus 5.5 dan Sonnet 5.5.
6. Claude Fable 5.2 (dan Varian Riset Mythos 5.2)
Diperkenalkan melalui rilis resmi Claude Fable 5.2 Anthropic pada 9 November 2026 seharga $8,00/$40,00 ($0,20 cached; fast mode $16/$80), model ini menyapu peringkat #1 AA v5.0.1 (64,6–65), #1 BenchLM (93,2), #1 WebDev (1823–1826 Elo), #1 Creative Writing (1529 Elo), dan #1 akurasi pengetahuan AA-Omniscience (79%).
Gunakan Fable 5.2 untuk rekayasa perangkat lunak tingkat staf, perombakan basis data korporasi, serta otomasi agen layar komputer (89,3% OSWorld 2.1). Sasarannya adalah tim core engineering dan arsitek data, sementara varian Mythos 5.2 dibatasi khusus organisasi terverifikasi keamanan siber dan biologi.
Hindari setelan max effort untuk pekerjaan harian karena menyedot rata-rata $26,54 per tugas dalam 46,8 menit. Pengujian Anthropic membuktikan level low atau medium sudah mampu melampaui skor puncak Opus 5.5 max dengan biaya kurang dari sepersepuluhnya.
7. Claude Opus 5.5
Dengan tarif $4,00/$20,00 ($0,20 cached) dan 128.000 token output maksimal, Opus 5.5 menempati #2 WebDev Arena (1818 Elo), #3 Creative Writing (1516 Elo), dan skor 59,1 di AA v5.0.1. Model ini sangat kuat menghasilkan komponen UI website, koding terminal ketat, serta artikel pilar panjang yang kaya argumentasi.
Penulis konten senior, agensi SEO, dan web developer pelanggan Claude Pro ($20 per bulan) atau Team akan merasakan manfaat langsungnya. Simpan panduan gaya bahasa dan data riset primer di dalam fitur Claude Projects agar Opus 5.5 tidak mengarang fakta, mengingat halusinasi closed-book-nya masih berada di angka 50,3%.
8. Claude Sonnet 5.5
Dipasarkan seharga $2,00/$10,00 ($0,20 cached), Sonnet 5.5 meraih #1 AA-Briefcase (1815 Elo), #3 WebDev (1771 Elo), dan #3 Vals Index (70,85%). Bagi tim konten in-house serta spesialis on-page SEO, ini adalah mesin paling seimbang untuk produksi artikel blog berbahasa Indonesia, penyuntingan landing page, skema JSON-LD, dan terjemahan kontrak bisnis.
Kunci hemat biaya pada Sonnet 5.5 adalah memakai level medium ($0,59 per tugas) atau high ($1,08 per tugas). Hindari pengaturan max via API karena outputnya bisa membengkak ke rata-rata 193.000 token per tugas ($7,60–$10,02), dan pastikan draf akhir tetap melalui proses penyuntingan manusia selaras panduan pengujian AI content detector.
Lini Varian Model OpenAI ChatGPT
Melalui pengumuman resmi GPT-6.2 Astra dan Sol pada 17 November 2026, OpenAI merombak efisiensi seri GPT-6 pada jendela konteks 1,05 juta token (maksimal 128K output) di Responses API, Codex, ChatGPT Work, dan GitHub Copilot.
9. GPT-6.2 Astra
Memangkas tarif 20% dibanding GPT-6 Astra lama menjadi $8,00 input ($0,40 cached) dan $40,00 output (cutoff 18 Mei 2026), GPT-6.2 Astra naik ke #2 AA Index v5.0.1 (skor 62 hanya seharga $4,00 per tugas), #2 BenchLM (91,1; #1 kategori Sains), dan #1 AA-3D (1318 Elo). Laporan OpenAI juga mencatat 97% di GPQA Diamond serta 100% di ExploitBench.
Arahkan Astra untuk pemodelan finansial ber-template ketat, riset sains/matematika ekstrem, dan pemodelan CAD/3D bagi analis kuantitatif serta arsitek sistem. Pakai Astra sebatas eskalasi berisiko tinggi dan selalu audit fakta maupun diff kode secara manual, mengingat halusinasinya mencapai 58,1%–59% serta Blocker Deception naik ke 22,28%.
10. GPT-6.2 Sol
Mempertahankan tarif $2,00/$10,00 ($0,10 cached) dengan knowledge cutoff lebih baru (1 Juni 2026), GPT-6.2 Sol melesat ke skor 57 di AA v5.0.1 dengan biaya indeks hanya $1,01 per tugas (9,4 menit)—menjadikannya bintang efisiensi Pareto. Pada Plotly Data Bench, Sol mencetak 40/43 hanya seharga $1,22 dalam 10,5 detik per soal (melanjutkan efisiensi GPT-6.1 Sol yang 43/43 seharga $2,61) dan diklaim menangkap hampir dua kali lebih banyak bug code review dibanding 6.1 Sol.
Tim analitik iklan, growth marketer, dan pengguna Codex dapat menjadikan GPT-6.2 Sol mesin default harian untuk kalkulasi ROAS serta otomasi koding. Perhatikan perubahan teknis seri 6.1/6.2: parameter temperature/top_p dihapus, opsi penalaran none ditiadakan, dan panggilan alat pindah ke Responses API; untuk tugas ekstraksi ringan tersedia GPT-6.1 Terra ($1/$5) dan GPT-6 Luna ($0,10/$0,50).
11. GPT-5.5 (Status Legacy)
Berbekal cutoff Desember 2025 dan tarif $5,00/$30,00 ($0,50 cached), GPT-5.5 pernah unggul di 84,9% GDPval dan 98,0% Tau2-Bench Telecom menurut data OpenAI. Namun, perannya kini terbatas untuk memelihara pipeline lama yang masih memakai endpoint Chat Completions.
Mengingat GPT-5.5 sudah dipensiunkan dari ChatGPT Codex pada 14 Oktober 2026 dan tarifnya 2,5 hingga 3 kali lebih mahal daripada GPT-6.2 Sol, pengembang baru sebaiknya langsung membangun integrasi di GPT-6.2 Sol atau GPT-6.1 Terra.
Lini Varian Model Open-Weight dan Spesialis Pencarian
Enam model berikut melengkapi ekosistem bagi tim yang membutuhkan pencarian web bersitasi, pemrosesan konteks super panjang, atau kebebasan server lokal tanpa ikatan royalti.
12. DeepSeek V4.1 Flash dan DeepSeek V4 Pro
Melalui rilis DeepSeek-V4.1-Flash (pembaruan 1017), DeepSeek menghadirkan arsitektur 552B MoE berlisensi MIT yang hanya mengaktifkan 8B parameter saat membaca dan 16B saat menulis (konteks 1 juta token, 384K output). Tarif off-peak-nya hanya $0,15/$0,60 ($0,30/$1,20 saat jam sibuk) dengan biaya uji AA v5.0.1 cuma $0,60 per tugas (skor 32–33), mendampingi V4 Pro (1,6T/49B aktif, 93,5% LiveCodeBench).
Duet ini sangat cocok bagi Technical SEO Specialist dan startup untuk programmatic SEO massal, pengelompokan puluhan ribu keyword, serta penulisan deskripsi meta katalog produk. Jadwalkan pekerjaan batch pada jam off-peak lewat API resmi atau OpenRouter untuk menekan anggaran serendah mungkin.
13. Perplexity Sonar
Terhubung langsung ke indeks web aktif (bermigrasi ke Agent API sejak 27 September 2026), lini Sonar mencakup Sonar standar ($1/$1, 128K konteks), Sonar Pro ($3/$15, 200K konteks, 57,8% GPQA Diamond), Sonar Reasoning Pro ($2/$8, 1139 Elo Search Arena), dan Sonar Deep Research ($2/$8).
Peneliti konten dan analis kompetitor memakainya untuk validasi klaim statistik serta memantau pergerakan harga pesaing tanpa membangun crawler sendiri. Perhitungkan biaya tambahan Search Fee ($2,50–$14 per 1.000 permintaan); analisis Spheron 2026 menunjukkan API Sonar paling ekonomis di bawah ~86.000 kueri/bulan (Sonar Pro) atau ~254.000 kueri/bulan (Sonar dasar), sementara di atas batas itu server RAG mandiri lebih hemat.
14. Grok 4.7
Dirilis 21 September 2026 dengan konteks 500K token (cutoff 31 Mei 2026) seharga $2,00/$6,00 ($0,50 cached), Grok 4.7 mencetak skor 35,5 di AA v5.0.1 ($7,77 per tugas), 71% DeepSWE 1.1, serta #1 CADGenBench (44,4%). Social Media Specialist dan tim reputasi merek memanfaatkannya untuk melacak sentimen krisis real-time di platform X serta koding cepat berbasis Cursor.
Pastikan panjang prompt tetap di bawah 200.000 token agar tidak terkena penggandaan tarif menjadi $4/$12. Selalu aktifkan pencarian langsung X ketika membahas peristiwa terkini di luar batas memori statisnya.
15. Meta Llama 4 Scout
Mengusung 109B parameter total dengan 17B parameter aktif dan context window 10 juta token, Llama 4 Scout mampu melaju hingga 2.600 token per detik (TTFT hanya 0,31 detik di DeepInfra) dengan tarif pihak ketiga mulai $0,08/$0,30.
Enterprise SEO Auditor dan Data Scientist menggunakannya untuk melahap file log server tahunan, memetakan internal link graph ribuan URL sekaligus, atau menjalankannya mandiri pada satu server GPU. Unduh bobotnya melalui Hugging Face dengan mencermati ketentuan Llama 4 Community License, atau panggil via penyedia seperti DeepInfra dan Lambda.
16. Qwen4-Max
Menggantikan Qwen 3.8 Max sejak 16 November 2026, Qwen4-Max membawa 2,4T parameter (71B aktif) dengan tarif lebih hemat 25% di $1,50 input ($0,075 cached) dan $4,50 output per 1 juta token. Walau Alibaba menonjolkan 75,7% DeepSWE v1.1, evaluasi independen menempatkannya di 42,9–43 AA v5.0.1 dengan halusinasi 28,4% dan waktu proses panjang (29,8 menit per tugas; TTFT 136,3 detik).
Tim operasional e-commerce lintas negara cocok memanfaatkannya untuk ekstraksi dokumen dan analisis materi teks-gambar-video berbiaya output murah. Jalankan Qwen4-Max khusus sebagai batch job latar belakang, bukan untuk chatbot interaktif berlatensi rendah.
17. Kimi K3.1 Pro
Dipublikasikan dalam format bobot terbuka MXFP4 (1,56 TB) pada repositori Hugging Face Kimi K3.1 Pro di bawah lisensi Modified MIT, model 2,8T MoE (104B aktif) ini bertarif resmi $2,00/$10,00 ($0,20 cached; mulai $0,2375/$8,41 di OpenRouter). Pada pengukuran independen v5.0.1, Kimi memimpin kelas open-weight (skor 46,5; #1 Terminal-Bench 4.0 di 67,2%; 1846 Elo GDPval-AA).
Perusahaan teknologi dan agensi analitik memakainya untuk agen kerja pengetahuan berdurasi panjang serta pengembangan aplikasi 3D web di infrastruktur privat. Aktifkan selalu cached input karena penalaran wajibnya menghasilkan sekitar 55.000 token output per tugas, atau pilih varian Highspeed ($4/$20) jika membutuhkan kecepatan respons di atas 31–52 token per detik.
AI Terbaik untuk Digital Marketing dan SEO: Orkestrasi Multi-LLM Berbasis Tugas

Hasil pengujian rutin lintas model dalam SOP operasional Thidiweb Digi membuktikan satu hal mendasar: tidak ada satu chatbot tunggal yang unggul di semua lini pekerjaan pemasaran. Memaksa satu model menangani riset, penulisan artikel panjang, koding skema, hingga audit iklan justru menurunkan mutu hasil sekaligus memboroskan anggaran.
Untuk menjaga standar layanan terbaik bagi klien, Thidiweb Digi menerapkan pendekatan Orkestrasi Multi-LLM Berbasis Tugas yang membagi alur kerja ke dalam lima lapisan presisi:
- Riset Kata Kunci, Grounding SERP & Audit Sitasi GEO: Gunakan Gemini 4 Hydrogen bersama Perplexity Sonar Pro. Keduanya menarik data SERP Google secara aktual dengan tingkat halusinasi rendah (8,5%) sekaligus memetakan sumber pesaing; untuk perangkat lunak riset operasionalnya, pelajari tools AI untuk SEO.
- Penulisan Artikel Pilar Panjang & Copywriting Bahasa Indonesia: Jangan serahkan penuh ke Gemini 4 Neon karena skor Creative Writing-nya turun ke 1502 Elo. Tetap andalkan Claude Sonnet 5.5 atau Claude Opus 5.5 (dengan suplai fakta riset dari tahap pertama) atau Gemini 4 Carbon untuk mempertahankan keluwesan tata bahasa Indonesia.
- Technical SEO, Skema JSON-LD & Audit Dokumen 1 Juta Token: Gunakan Gemini 4 Neon (high) atau orkestrasi Neon + Hydrogen di Google Antigravity untuk debugging lintas file dan validasi skema JSON-LD. Eskalasikan ke Claude Opus 5.5 / Fable 5.2 khusus rekayasa antarmuka UI front-end.
- Analisis Data Kampanye Google Ads & Kalkulasi ROAS: Gunakan GPT-6.2 Sol (40/43 Plotly seharga $1,22 dalam 10,5 detik) atau Gemini 4 Hydrogen di Google Sheets. Hindari memakai Neon untuk kueri spreadsheet berulang karena sifat verbose-nya memicu biaya $17,03 di Plotly; untuk optimalisasi algoritma iklannya, simak panduan Performance Max Google Ads.
- Otomasi Programmatic SEO & Audit Log Server Masif: Pakai DeepSeek-V4.1-Flash ($0,15/$0,60 off-peak) untuk klasifikasi ribuan kata kunci, atau Meta Llama 4 Scout (konteks 10 juta token) untuk membedah log perayapan Googlebot tahunan sekaligus.
Pada implementasi di lingkungan bisnis—seperti tim pemasaran distributor bahan bangunan nasional maupun klien yang Kami dampingi—pemisahan peran ini terbukti menekan waktu produksi tanpa mengorbankan akurasi. Untuk merancang tata kelola tim internal dan efisiensi anggaran pemasaran secara menyeluruh, Anda bisa membaca panduan penerapan AI untuk bisnis.
Protokol Teknis Migrasi API Gemini 4 Argon ke Neon

Bagi tim pengembang perusahaan yang saat ini masih memanggil endpoint gemini-4-argon, mengganti nama model secara langsung tanpa penyesuaian parameter berisiko memunculkan error HTTP 400 atau pembengkakan biaya sementara. Berikut lima langkah migrasi aman sekaligus simulasi perhitungannya.
📊 Simulasi Praktis Batas Rasio Token Migrasi Argon ke Neon:
Batas Rasio Token Neon = Tarif per 1M Token Argon ÷ Tarif per 1M Token Neon
(Patokan estimasi kerja praktis dengan asumsi rasio input-ke-output identik 1:5)
Contoh Kasus & Simulasi Biaya Bulanan: Melanjutkan kasus perusahaan SaaS akuntansi dan pajak di Jakarta dengan beban 500 tugas analisis regulasi kompleks per bulan, berikut perhitungan titik impas dan selisih anggarannya berdasarkan biaya per tugas AA Index pasca-1 Desember 2026:
- Jalur Promo (20–30 November 2026 — Argon $2/$10 vs Neon $3/$15): Batas rasio = 2 ÷ 3 = 0,67×. Sebelum 1 Desember, Neon baru lebih murah jika memakai kurang dari 0,67× total token Argon.
- Tarif Standar (Mulai 1 Desember 2026 — Argon $4/$20 vs Neon $3/$15): Batas rasio = 4 ÷ 3 = 1,33×. Neon otomatis lebih hemat selama pemakaian tokennya tidak melebihi 1,33× token Argon.
- Perbandingan Biaya 500 Tugas/Bulan Pasca-1 Desember: Bertahan di Argon high ($9,95/tugas) menghabiskan 500 × $9,95 = $4.975/bulan. Pindah ke Neon high ($3,74/tugas, skor 60) hanya menelan 500 × $3,74 = $1.870/bulan—menghemat $3.105/bulan (62,4%). Jika memakai Neon medium ($1,90/tugas, skor 55 masih +5 poin di atas Argon high), biayanya turun ke $950/bulan atau hemat $4.025/bulan (81%).
Setelah memahami perhitungan ekonominya, jalankan lima protokol teknis berikut agar transisi berjalan mulus:
- Kelola Jendela Cutover: Jalankan shadow traffic (5%–10% beban kerja) sepanjang 20–30 November 2026, lalu lakukan perpindahan penuh tepat sebelum tarif Argon naik dua kali lipat pada 1 Desember 2026.
- Kunci Parameter thinking_level: Argon ber-default
medium, sedangkan Neon ber-defaulthigh(dan menolak opsiminimaldengan error). Uji levelmediumpada Neon terlebih dahulu karena kecepatannya tiga kali lipat lebih tinggi. - Bersihkan Parameter Sampling & Timeout: Hapus
temperature,top_p,top_k, dan explicit caching (Neon memakai implicit caching 95% otomatis), naikkanmax_output_tokensminimal ke 65.536, perpanjang timeout klien minimal 15 menit (atau aktifkanbackground=True), serta pakai native function calling. - Pasang Lima Guardrails Anti-Halusinasi: Untuk menggantikan ketelitian closed-book Argon high (2,22 salah/100 soal), wajib aktifkan cek kutipan verbatim ke sumber, token penolakan eksplisit (misal
NOT_IN_DOC), skema keluaranresponseSchema, grounding Google Search/RAG, serta pengujian rutin pada pertanyaan tak terjawab. - Isolasi Sandbox Mutlak bagi Agen Otonom: Belajar dari insiden Epoch AI, jangan mengandalkan safeguards penyedia saja. Jalankan seluruh agen eksekusi kode di dalam sandbox ber-firewall default-deny dengan hak akses minimal serta tinjauan manusia.
Perbedaan LLM Open-Source, Open-Weights, dan Proprietary

Menentukan pilihan antara layanan API tertutup atau memasang model terbuka di server lokal berdampak langsung pada kepatuhan regulasi privasi dan struktur biaya jangka panjang. Katalog industri Gradually.ai melacak 303 model dari 39 pengembang global yang terbagi menjadi 136 model proprietary, 161 model open-weights, dan hanya 6 model open-source murni.
Satu pembaruan penting perlu dicatat oleh jajaran pengambil keputusan: pada skala AA Intelligence Index v5.0.1 terbaru, kesenjangan kecerdasan antara model proprietary tertinggi (Claude Fable 5.2 di 64,6) dan open-weight terkuat (Kimi K3.1 Pro di 46,5) kembali melebar menjadi sekitar 18 poin.
Sebagai gambaran keputusan pada jaringan klinik kesehatan atau lembaga keuangan terregulasi di Indonesia, terdapat dua jalur utama. Skenario pertama memakai API proprietary (Gemini 4 Neon atau Claude) demi kecepatan implementasi tanpa belanja modal server GPU (CapEx $0), dengan syarat wajib mengaktifkan kontrak Zero Data Retention.
Sebaliknya, skenario kedua memilih self-hosting model open-weight (Kimi K3.1 Pro, DeepSeek V4.1 Flash, atau Llama 4 Scout) di server lokal ketika volume permintaan melampaui titik impas bulanan dan aturan privasi melarang data rekam medis maupun nasabah keluar dari infrastruktur internal.
Pertanyaan yang Sering Diajukan Seputar Large Language Model
Berikut adalah tujuh pertanyaan paling sering diajukan pemilik usaha dan praktisi pemasaran digital mengenai pemilihan, pembaruan model, serta penerapan LLM untuk bisnis di Indonesia.
Maksimalkan Strategi SEO dan GEO Bisnis Anda Bersama Thidiweb Digi
Mengikuti laju pembaruan puluhan model AI—terlebih ketika survei GWI Q2 2026 mencatat baru 9,9% pengguna internet Indonesia yang berlangganan AI berbayar—menuntut waktu, pengujian rutin, serta pengawasan editor berpengalaman agar website Anda terhindar dari konten generik dan kesalahan data. Melalui SOP pengujian lintas-LLM yang terus Kami perbarui, Thidiweb Digi memadukan ketepatan riset SERP Google, kualitas tulisan manusia, dan struktur teknis yang siap dikutip mesin pencari AI.
Jika Anda ingin mengamankan pertumbuhan trafik organik sekaligus visibilitas merek tanpa harus pusing mengelola orkestrasi teknisnya sendiri, percayakan pengembangan aset digital perusahaan Anda melalui layanan optimasi SEO dan GEO bersama tim ahli Kami.

